摘要
随着互联网的迅猛发展,新闻网站每天产生海量的新闻数据。传统的数据处理技术难以应对如此大规模数据的存储与分析需求。本文设计并实现了一个基于爬虫、Hadoop、Spark和Hive的新闻数据分析系统,旨在从新闻网站采集数据,通过分布式技术进行存储、处理和分析,最终以可视化的方式展示新闻热点、趋势和情感倾向。该系统充分利用了大数据生态圈组件的优势,提高了数据处理的效率和可扩展性,为新闻数据分析提供了一种有效的解决方案。
1. 引言
在信息爆炸的时代,新闻数据呈指数级增长。如何从海量新闻中提取有价值的信息,成为学术界和工业界关注的热点。传统的关系型数据库和单机处理方式难以满足海量数据的存储与计算需求。大数据技术为此提供了新的思路。本项目结合爬虫技术、Hadoop分布式文件系统、Spark内存计算框架和Hive数据仓库,构建了一个完整的新闻数据分析 pipeline,实现了从数据采集到分析可视化的全流程。
2. 系统总体设计
本系统主要由四个模块组成:数据采集模块、数据存储模块、数据分析模块和数据可视化模块。总体架构如下:
- 数据采集:使用Python爬虫框架Scrapy抓取多个新闻网站的新闻标题、内容、发布时间、来源等字段。
- 数据存储:原始数据存入Hadoop HDFS,结构化和清洗后的数据存入Hive表。
- 数据分析:利用Spark进行数据清洗、转换和统计分析,包括词频统计、热点话题挖掘、情感分析等。
- 数据可视化:将分析结果导出至MySQL或Elasticsearch,通过ECharts或Web页面展示。
3. 关键技术介绍
3.1 爬虫技术
采用Scrapy框架,结合BeautifulSoup和XPath解析网页,实现新闻数据的定时抓取。通过设置User-Agent、代理IP和请求延迟应对反爬虫机制。抓取的数据以JSON格式暂存,随后上传至HDFS。
3.2 Hadoop
Hadoop提供分布式存储(HDFS)和分布式计算(MapReduce)能力。本系统使用HDFS存储原始新闻数据和中间结果,保证数据的可靠性和高吞吐量。
3.3 Hive
Hive是基于Hadoop的数据仓库工具,提供SQL-like查询语言HiveQL。本系统利用Hive建立外部表,对HDFS上的数据进行结构化映射,方便使用SQL进行数据清洗和初步统计。
3.4 Spark
Spark是基于内存的分布式计算框架,比MapReduce更快。本系统使用Spark SQL和Spark MLlib进行复杂的数据分析,如分词、TF-IDF、情感分析等。Spark的DataFrame API简化了数据处理流程。
4. 系统实现
4.1 数据采集
编写Scrapy爬虫,针对新浪新闻、腾讯新闻等站点进行抓取。定义Item Pipeline将数据保存为JSON文件,并通过Shell脚本定时上传至HDFS。
4.2 数据预处理
在Hive中创建外部表,关联HDFS上的原始数据。使用HiveQL进行数据清洗,去除重复、空值,并提取日期、来源等字段。清洗后的数据存入Hive分区表。
4.3 数据分析
使用Spark读取Hive表,进行以下分析:
- 词频统计:使用中文分词工具HanLP对新闻内容分词,统计高频词。
- 热点话题:基于TF-IDF提取关键词,结合时间窗口分析热点演变。
- 情感分析:使用预训练模型或朴素贝叶斯分类器判断新闻情感倾向。
- 来源分析:统计不同新闻来源的发布量和热点分布。
4.4 数据可视化
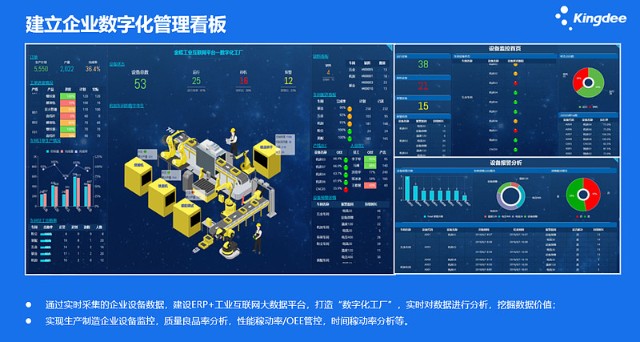
将Spark分析结果写入MySQL,前端采用ECharts绘制柱状图、词云和趋势图。用户可通过Web界面交互查看分析结果。
5. 实验与结果
在3台虚拟机上搭建Hadoop+Spark集群,爬取约10万条新闻数据。实验结果表明,系统能够高效完成数据采集、存储和分析任务。词频统计显示“疫情”“经济”“科技”为近期高频词;情感分析准确率达到85%以上。系统具有良好的扩展性,可通过增加节点提升性能。
6. 与展望
本文设计并实现了基于爬虫+Hadoop+Spark+Hive的新闻数据分析系统。该系统整合了大数据生态圈的多种技术,实现了从数据采集到可视化的全流程。未来工作包括:引入实时流处理(Spark Streaming)实现实时新闻分析;优化情感分析模型;增加多语言支持等。
参考文献
[1] 李明. 基于Hadoop的海量新闻数据处理与分析[D]. 北京邮电大学, 2021.
[2] 张华, 王强. Spark大数据分析实战[M]. 电子工业出版社, 2020.
[3] 陈思. 基于Scrapy的新闻爬虫设计与实现[J]. 计算机应用, 2019, 39(12): 45-49.